Web scraping AI: wybierz ograniczone zadanie ekstrakcji albo narzędzie do scrapingu
Scraping AI wykorzystuje sztuczną inteligencję do automatyzacji pobierania danych ze stron internetowych, aby zbierać i przetwarzać dane wydajniej i inteligentniej niż metodami ręcznymi, zgodnie z definicją scrapingu AI firmy IBM. Aby podjąć praktyczną decyzję, zacznij od zadania, a nie od produktu. Wymień adresy URL źródeł, określ kolumny wyjściowe, opisz sposób obsługi brakujących lub niepewnych wartości i zdecyduj, które wiersze wymagają sprawdzenia. Wybierz ograniczone zadanie ekstrakcji dla jednego zamkniętego pakietu i jednego zaakceptowanego pliku. Wybierz narzędzie do scrapingu, gdy te same źródła i schemat muszą działać według harmonogramu, a Ty chcesz zarządzać potokiem. Przed wyborem którejkolwiek drogi unikaj pobierania prywatnych danych, przeciążania serwerów i plagiatowania treści oraz przestrzegaj odpowiednich przepisów dotyczących zbierania danych, zgodnie z wytycznymi etycznymi IBM.
Czym jest scraping AI?
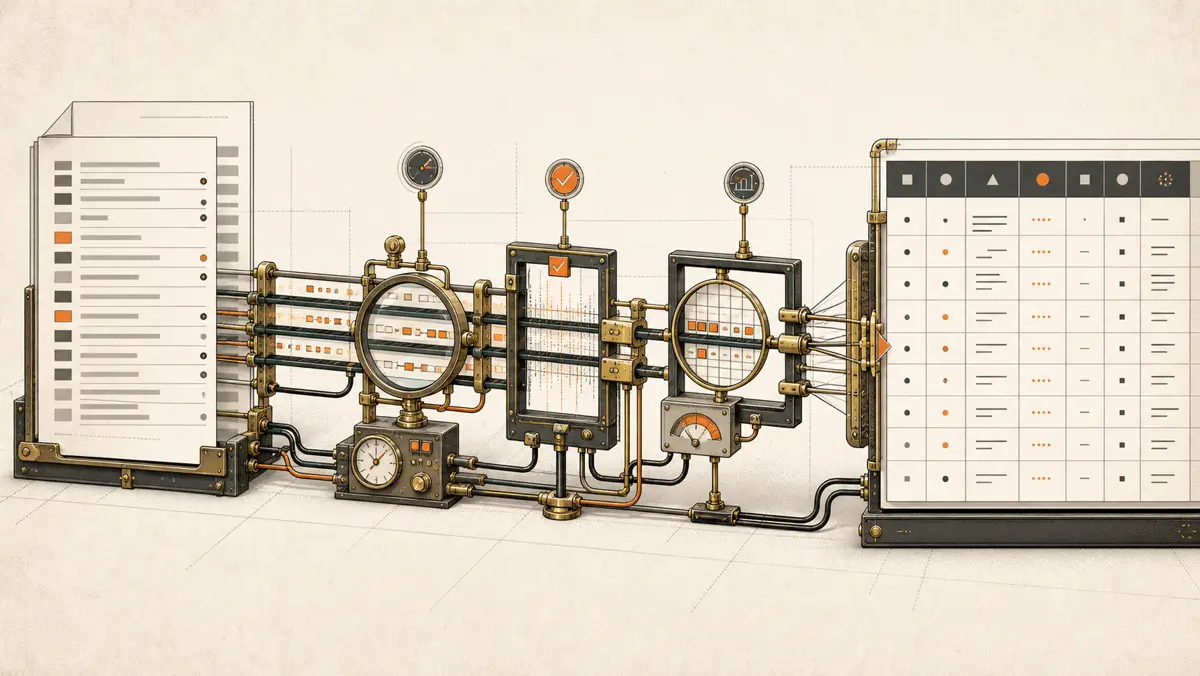
Scraping AI to pobieranie danych ze stron internetowych sterowane przez modele, które interpretują treść, a nie tylko przez stałe selektory stron. IBM definiuje ten termin jako wykorzystanie sztucznej inteligencji do automatyzacji pobierania danych ze stron internetowych i przetwarzania zebranych danych w swoim omówieniu scrapingu AI.
Tradycyjne scrapery korzystają z selektorów CSS, wyrażeń XPath i zakodowanej logiki. Ekstrakcja wspomagana przez AI może interpretować znaczenie treści i pracować z materiałami takimi jak obrazy, diagramy i pliki PDF, zgodnie z porównaniem tradycyjnego scrapingu i scrapingu AI firmy IBM. Ta różnica opisuje metodę ekstrakcji. Nie rozstrzyga, czy potrzebujesz stałego produktu do scrapingu.
Dla operatora użytecznym punktem wyjścia jest pisemny opis zadania. Zamienia on polecenie "pobierz dane z tych stron" w plik, który można sprawdzić i zaakceptować.
- Wymień adresy URL lub domeny źródłowe objęte realizacją.
- Określ kolumny wyjściowe, typy pól i przykład poprawnego wiersza.
- Opisz, co zapisać, gdy brakuje pola lub dwie wartości są sprzeczne.
- Zachowaj adres URL źródła przy każdym wierszu, gdy plik wymaga ścieżki dowodowej.
- Oznacz przypadki, które człowiek musi sprawdzić przed dalszym użyciem.
- Ustal, czy zadanie kończy się na jednym pakiecie, czy przechodzi w powtarzalne monitorowanie.
Reguła decyzji: jeśli nie potrafisz określić źródeł, pól i zasad sprawdzania, nie jesteś gotowy do porównywania produktów do scrapingu.
Jakie narzędzie do scrapingu AI najlepiej pasuje do Twojego zadania?
Najlepszy wybór pasuje do listy źródeł, schematu wyjściowego, częstotliwości i decyzji o odpowiedzialności. Ogólna lista narzędzi nie może podjąć tej decyzji, ponieważ wymienione produkty rozwiązują różne zadania. Zestawienie Gumloop obejmuje w jednej kategorii bezkodowe edytory przepływów pracy, scrapery na komputery, rozszerzenia przeglądarki i interfejsy API dla programistów oraz zaleca testowanie produktów na własnych stronach w porównaniu scraperów AI.
Użyj tej tabeli, aby wybrać model operacyjny przed wyborem marki.
| Punkt decyzji | Ograniczone zadanie ekstrakcji | Narzędzie do scrapingu lub API |
|---|---|---|
| Źródła | Zamknięta lista adresów URL lub domen dla zaakceptowanego pakietu | Te same źródła wracają według ustalonego harmonogramu |
| Wynik | Jedna uporządkowana tabela z uzgodnionymi kolumnami | Potok, który stale tworzy dane według uzgodnionego schematu |
| Sprawdzanie | Słabe lub sprzeczne wiersze otrzymują flagi do sprawdzenia | Twój zespół odpowiada za obsługę sprawdzania w działającym potoku |
| Obsługa | Realizacja kończy się po dostarczeniu i akceptacji | Twój zespół odpowiada za monitorowanie, prompty lub selektory, ponowne próby i awarie |
| Następna decyzja | Powtarzaj zadanie tylko świadomie | Utrzymuj konfigurację i działanie produktu |
Monitor bez kodu pasuje do zadania, w którym te same strony wymagają zaplanowanych kontroli i obsługi zmian. Browse AI jest przedstawiane jako rozwiązanie do scrapingu i monitorowania oraz dla użytkowników nietechnicznych w porównaniu narzędzi Browse AI. API dla programistów pasuje do aplikacji lub agenta, który potrzebuje treści strony lub uporządkowanych pól z adresów URL. Ograniczone zadanie pasuje do zamkniętej listy źródeł, znanych kolumn i jednej dostawy.
Nie traktuj publicznego testu porównawczego ani dyskusji jako dowodu akceptacji dla swoich źródeł. Wątek na Reddicie o nieudanym scrapingu w rzeczywistym zastosowaniu jest pojedynczą relacją, a nie dowodem, że dana metoda zadziała lub zawiedzie na Twoich stronach w tej dyskusji r/webscraping.
Reguła wyboru: najpierw porównaj modele operacyjne. Przetestuj wybraną drogę na dokładnych adresach URL i kolumnach z opisu zadania.
Czy ChatGPT może wykonywać web scraping?
ChatGPT może w niektórych przypadkach pobierać strony internetowe, ale Gumloop stwierdza, że nie potrafi samodzielnie w pełni zescrapować strony. Gumloop kieruje czytelników do specjalnych narzędzi do scrapingu, gdy przepływ pracy wymaga zarówno ekstrakcji, jak i rozumowania modelu w swoim przewodniku po scraperach AI.
Odpowiedź czatu dotycząca jednego adresu URL różni się więc od przekazania wyniku ekstrakcji. Przekazanie opisane w tym briefie zawiera listę źródeł, schemat, zasady dla brakujących lub zablokowanych stron, flagi do sprawdzenia i jeden plik, który odbiorca może zweryfikować. Jeśli chcesz tylko sprawdzić, czy określone pola występują na określonych stronach, zdefiniuj ograniczony pakiet. Jeśli zaakceptowane dane mają być odświeżane w arkuszu, interfejsie API lub agencie, oceń produkt do scrapingu dla tego powtarzalnego zadania.
Ta sama granica obowiązuje, gdy strony zawierają dane nieustrukturyzowane. Ekstrakcja wspomagana przez AI może interpretować znaczenie treści zgodnie z porównaniem IBM ze stałymi selektorami. Specjalne narzędzie do scrapingu zapewnia warstwę ekstrakcji, która przekazuje treść strony do modelu zgodnie z przewodnikiem Gumloop. Programiści również omawiają ten podział podczas pracy z nieustrukturyzowanymi danymi ze stron internetowych, ale wątek społeczności nie jest dokumentacją produktu w tej dyskusji programistów OpenAI.
Użyj tych pytań, aby eksperyment z ChatGPT nie zmienił się w nieokreślone zadanie produkcyjne:
- Które dokładne adresy URL obejmuje zakres?
- Jakie kolumny musi zawierać wynik?
- Jaka wartość oznacza brakujące pole?
- Które konflikty lub niepewne wiersze wymagają sprawdzenia?
- Czy zadanie kończy się po zaakceptowaniu jednego pliku, czy musi być powtarzane według harmonogramu?
Czy mogę użyć AI do scrapingu stron jako ograniczonego zadania?
Tak, jeśli przed rozpoczęciem potrafisz określić źródła, schemat, dowody, regułę sprawdzania i warunek zakończenia. Ograniczone zadanie jest umową wykonawczą dotyczącą jednego wyniku. Nie stanowi twierdzenia, że każde źródło jest dostępne ani że każda pobrana wartość jest gotowa do użycia.
Napisz opis zadania w tej kolejności:
- Źródła. Wymień dokładne adresy URL albo zdefiniuj zasadę włączania domen. Usuń każde źródło, które nie przejdzie kontroli dostępu i zgodności, zgodnie z wytycznymi IBM dotyczącymi zgodności etycznej i prawnej.
- Pola. Podaj nazwę każdej kolumny, jej typ i przykład poprawnego wiersza.
- Zasady dla pustych i sprzecznych wartości. Określ, co zapisać w wyniku, gdy brakuje pola lub dwie wartości na stronie są sprzeczne.
- Dowody. Wymagaj adresu URL źródła przy każdym wierszu, gdy odbiorca musi sprawdzić ekstrakcję.
- Kontrola człowieka. Określ, które słabe, puste lub sprzeczne przypadki blokują dalsze użycie.
- Częstotliwość. Określ, czy dostarczenie wyniku kończy zadanie, czy ten sam opis ma być realizowany ponownie.
Wynik musi odpowiadać opisowi zadania. Użyteczne przekazanie zawiera uporządkowaną tabelę, zachowane adresy URL źródeł, jeśli były wymagane, widoczne flagi do sprawdzenia i jasny zapis pominiętych lub pustych przypadków. Akceptacja oznacza, że odbiorca może sprawdzić plik na podstawie wymienionych źródeł i zasad. Jeśli to samo zadanie ma się powtarzać, zaakceptowany pakiet staje się dowodem potrzebnym do decyzji o narzędziu do scrapingu.
Reguła dowodowa: wiersz bez dowodu wymaganego w opisie zadania jest niekompletny, nawet gdy pobrana wartość wygląda wiarygodnie.
Jakie są kryteria przekazania realizacji scrapingu AI?
Przekazanie jest zaliczone, gdy dostarczony plik jest zgodny z uzgodnionym schematem i pokazuje każdy przypadek, który według reguły kontroli wymaga sprawdzenia. Celem nie jest dopracowana demonstracja. Celem jest możliwy do sprawdzenia artefakt powiązany z listą źródeł.
Sprawdź dostawę na podstawie opisu zadania:
- Każda dostarczona kolumna ma uzgodnioną nazwę i typ.
- Brakujące wartości stosują uzgodnioną regułę pustej wartości.
- Sprzeczne wartości stosują uzgodnioną regułę konfliktu.
- Każdy wiersz zachowuje swój adres URL źródła, gdy wymagano dowodu.
- Każdy słaby wiersz ma uzgodnioną flagę do sprawdzenia.
- Pominięte źródła pozostają widoczne, zamiast znikać z przekazanego pliku.
- Dostawa określa, czy zadanie zostało zakończone, czy będzie powtarzane.
Te kryteria pokazują również, czy po wykonaniu pakietu potrzebujesz oprogramowania. Jeśli jeden zaakceptowany plik zamyka zadanie, ograniczone zadanie jest zakończone. Jeśli te same źródła i schemat muszą wracać według harmonogramu, następna decyzja obejmuje narzędzie, monitorowanie, prompty lub selektory, ponowne próby i odpowiedzialność za potok. Ta decyzja zaczyna się od sprawdzonego wyniku, a nie od ogólnej tabeli funkcji.
Nie dodawaj pól po ekstrakcji bez aktualizacji opisu zadania. Nowe pole zmienia schemat i kontrolę akceptacji. Ogranicz wymagany artefakt tak, aby osoba sprawdzająca mogła porównać wiersze ze źródłami i rozstrzygnąć oznaczone przypadki.
Czy scraping danych z użyciem AI jest legalny?
Ten artykuł nie zawiera porady prawnej ani uniwersalnej reguły legalności. IBM stwierdza, że web scraping nie jest z natury nielegalny ani nieetyczny, ale może stać się problematyczny, gdy jest wykonywany nieetycznie w omówieniu etyki scrapingu AI. IBM stwierdza również, że osoby wykonujące scraping muszą zbierać dane etycznie i przestrzegać odpowiednich przepisów dotyczących zbierania danych w tych samych wytycznych.
Sprawdź każde źródło przed realizacją. Zabezpieczone strony mogą wymagać uwierzytelnienia, a IBM stwierdza, że scrapery AI mogą z nich korzystać, gdy warunki witryny zezwalają na dostęp. IBM wskazuje też pobieranie prywatnych danych, przeciążanie serwerów i plagiatowanie treści jako działania powszechnie uważane za nieetyczne. Osoby wykonujące scraping muszą przestrzegać odpowiednich przepisów dotyczących zbierania danych zgodnie z wytycznymi IBM dotyczącymi etyki scrapingu AI.
Jeśli źródło nie przejdzie tych kontroli, usuń je z listy źródeł. Ograniczone zadanie ogranicza uzgodniony pakiet.
Kiedy należy przejść z ograniczonego zadania na narzędzie do scrapingu?
Przejdź na narzędzie, gdy zaakceptowane źródła i schemat muszą działać według harmonogramu, a Ty jesteś przygotowany do zarządzania potokiem. Odpowiedzialność obejmuje monitorowanie, selektory lub prompty, ponowne próby i obsługę awarii. Pozycjonowanie Browse AI jako narzędzia do scrapingu i monitorowania jest przykładem produktu przeznaczonego do powtarzalnych przepływów pracy ze stronami w opublikowanym porównaniu narzędzi.
Pozostań przy ograniczonym zadaniu, gdy lista źródeł jest zamknięta, schemat jest znany, a jedna zaakceptowana tabela kończy zlecenie. Przejdź na narzędzie, gdy to samo zadanie musi działać nadal. Jeśli źródła lub pola wciąż nie są jasne, popraw opis zadania przed oceną produktów.
Sekwencja jest krótka:
- Określ listę źródeł i schemat.
- Wykonaj jedną ograniczoną ekstrakcję.
- Sprawdź dowody i oznaczone wiersze.
- Zaakceptuj lub popraw przekazany wynik.
- Wybierz narzędzie do pracy cyklicznej tylko wtedy, gdy zaakceptowane zadanie musi być kontynuowane.
Ta sekwencja precyzuje decyzję zakupową. Wybierasz oprogramowanie dla sprawdzonego zestawu źródeł, schematu i reguły kontroli, zamiast kupować etykietę kategorii.
Autor: Tileo, operator Pitstop.