Scraping par IA : choisir une mission d'extraction cadrée ou un outil de scraping
Selon la définition du scraping par IA d'IBM, le scraping par IA utilise l'intelligence artificielle pour automatiser l'extraction de données de sites web, afin de recueillir et de traiter les données plus efficacement et plus intelligemment qu'avec des méthodes manuelles. Pour prendre une décision concrète, commencez par la mission, pas par le produit. Nommez les URL sources, définissez les colonnes de sortie, indiquez comment traiter les valeurs manquantes ou incertaines et décidez quelles lignes doivent être vérifiées. Utilisez une mission d'extraction cadrée pour un lot fermé et un fichier accepté. Choisissez un outil de scraping lorsque les mêmes sources et le même schéma doivent être traités régulièrement et que vous voulez exploiter le pipeline. Avant de choisir l'une de ces voies, évitez de collecter des données privées, de surcharger les serveurs ou de plagier du contenu. Respectez aussi les cadres réglementaires applicables à la collecte de données, conformément aux recommandations éthiques d'IBM.
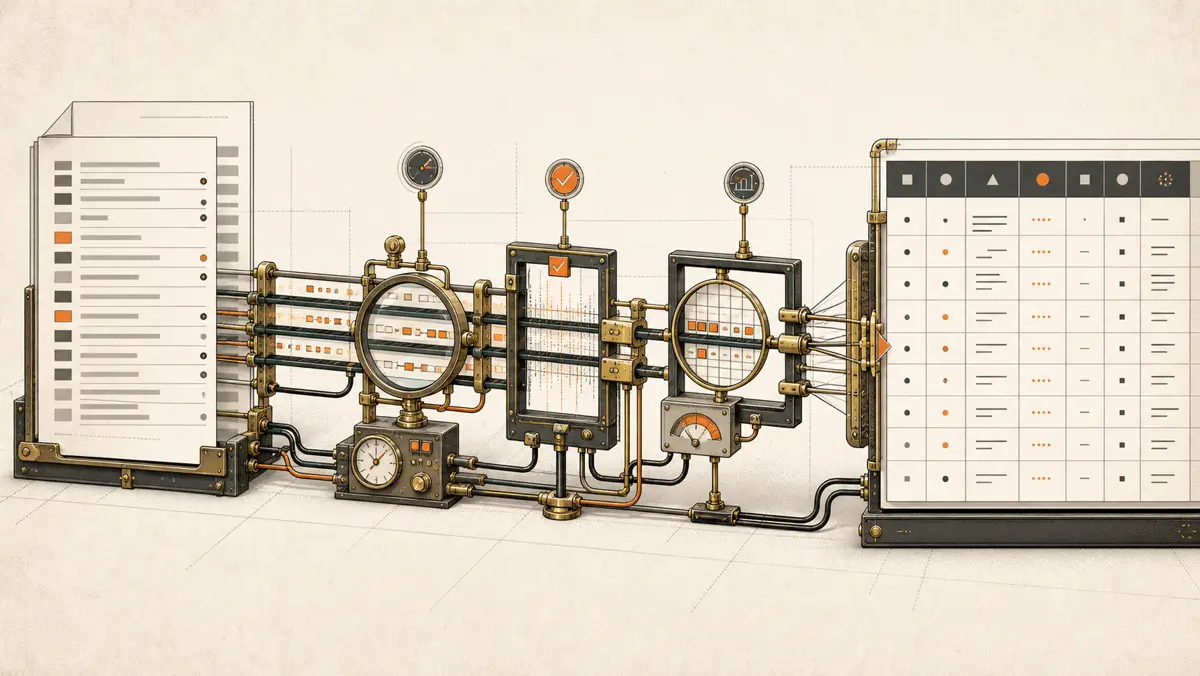
Qu'est-ce que le scraping par IA ?
Le scraping par IA est une extraction de données web guidée par des modèles qui interprètent le contenu, et pas seulement par des sélecteurs de page fixes. IBM définit ce terme comme l'utilisation de l'intelligence artificielle pour automatiser l'extraction depuis des sites web et traiter les données collectées dans sa présentation du scraping par IA.
Les scrapers web classiques utilisent des sélecteurs CSS, des expressions XPath et une logique codée en dur. Selon la comparaison d'IBM entre scraping classique et scraping par IA, l'extraction assistée par IA peut interpréter le sens du contenu et traiter des entrées telles que des images, des schémas et des PDF. Cette distinction décrit la méthode d'extraction. Elle ne détermine pas si vous avez besoin d'un produit de scraping permanent.
Pour un opérateur, le point de départ utile est un brief de mission écrit. Il transforme « scrapez ces sites » en un fichier qu'une personne peut vérifier et accepter.
- Nommez les URL sources ou les domaines inclus dans l'exécution.
- Définissez les colonnes de sortie, les types de champs et un exemple de ligne valide.
- Indiquez ce qu'il faut enregistrer lorsqu'un champ manque ou que deux valeurs se contredisent.
- Conservez l'URL source avec chaque ligne lorsque le fichier exige une piste de preuves.
- Marquez les cas qu'un humain doit vérifier avant toute utilisation ultérieure.
- Fixez la condition d'arrêt : un lot ou un suivi récurrent.
Règle de décision : si vous ne pouvez pas préciser les sources, les champs et la règle de vérification, vous n'êtes pas prêt à comparer des produits de scraping.
Quel est le meilleur outil de scraping par IA pour votre mission ?
Le meilleur choix est celui qui correspond à votre liste de sources, à votre schéma de sortie, à votre cadence et à votre décision de propriété. Une liste générique d'outils ne peut pas prendre cette décision, car les produits cités répondent à des missions différentes. Le panorama de Gumloop regroupe des canevas de workflow sans code, des scrapers de bureau, des extensions de navigateur et des API pour développeurs dans une même catégorie. Il conseille aussi de tester les produits sur vos propres pages dans son comparatif des scrapers web par IA.
Utilisez ce tableau pour choisir le modèle d'exploitation avant de choisir une marque.
| Point de décision | Mission d'extraction cadrée | Outil ou API de scraping |
|---|---|---|
| Sources | Une liste fermée d'URL ou de domaines pour le lot accepté | Les mêmes sources reviennent selon une cadence définie |
| Sortie | Un tableau structuré avec les colonnes convenues | Un pipeline qui continue de produire le schéma convenu |
| Vérification | Les lignes fragiles ou contradictoires portent des marqueurs de vérification | Votre équipe gère la vérification dans le pipeline actif |
| Exploitation | L'exécution s'arrête après la livraison et l'acceptation | Votre équipe gère le suivi, les prompts ou sélecteurs, les nouvelles tentatives et les échecs |
| Décision suivante | Ne répéter la mission que de façon délibérée | Maintenir la configuration et le fonctionnement du produit |
Un outil de suivi sans code convient lorsqu'il faut vérifier régulièrement les mêmes pages et gérer leurs changements. Browse AI est présenté pour les workflows de scraping et de suivi ainsi que pour un usage non technique dans le comparatif d'outils de Browse AI. Une API pour développeurs convient à une application ou à un agent qui doit obtenir le contenu de pages ou des champs structurés à partir d'URL. Une mission cadrée convient à une liste de sources fermée, à des colonnes connues et à une livraison unique.
Ne considérez pas un benchmark public ou un fil de discussion comme une preuve d'acceptation pour vos sources. Un fil Reddit sur l'échec d'un scraping en conditions réelles est un témoignage anecdotique. Il ne prouve pas qu'une méthode réussira ou échouera sur vos pages dans cette discussion de r/webscraping.
Règle de sélection : comparez d'abord les modèles d'exploitation. Testez une voie présélectionnée avec les URL et les colonnes exactes du brief.
ChatGPT peut-il faire du web scraping ?
ChatGPT peut récupérer des sites web dans certains cas, mais Gumloop indique qu'il ne peut pas scraper entièrement une page web tout seul. Gumloop oriente les lecteurs vers des outils de scraping dédiés lorsqu'un workflow exige à la fois l'extraction et le raisonnement d'un modèle dans son guide des scrapers par IA.
Une réponse de chat portant sur une URL n'est donc pas un livrable d'extraction. Le livrable défini dans ce brief comprend une liste de sources, un schéma, des règles pour les pages manquantes ou bloquées, des marqueurs de vérification et un fichier que le destinataire peut contrôler. Si votre question immédiate consiste à savoir si des champs nommés existent sur des pages nommées, définissez un lot borné. Si la sortie acceptée doit alimenter régulièrement une feuille de calcul, une API ou un agent, évaluez un produit de scraping pour cette mission récurrente.
La même limite s'applique lorsque les pages contiennent du contenu non structuré. L'extraction assistée par IA peut interpréter le sens du contenu selon la comparaison d'IBM avec les sélecteurs fixes. Un outil de scraping dédié fournit la couche d'extraction qui transmet le contenu de la page à un modèle selon le guide de Gumloop. Les développeurs discutent aussi de cette séparation lorsqu'ils travaillent avec des données web non structurées, mais un fil communautaire n'est pas une documentation produit dans la discussion des développeurs OpenAI.
Utilisez ces questions pour éviter qu'une expérience avec ChatGPT ne devienne une tâche de production indéfinie :
- Quelles URL exactes sont incluses dans le périmètre ?
- Quelles colonnes la sortie doit-elle contenir ?
- Quelle valeur représente un champ manquant ?
- Quels conflits ou quelles lignes incertaines exigent une vérification ?
- La mission s'arrête-t-elle après l'acceptation d'un fichier ou doit-elle se répéter selon une cadence ?
Puis-je utiliser l'IA pour scraper des sites web dans le cadre d'une mission ?
Oui, si vous pouvez définir les sources, le schéma, les preuves, la règle de vérification et la condition d'arrêt avant l'exécution. La mission cadrée est un contrat d'exécution pour une sortie. Elle ne prétend pas que toutes les sources sont accessibles ni que chaque valeur extraite est prête à l'emploi.
Rédigez le brief dans cet ordre :
- Sources. Listez les URL exactes ou définissez la règle d'inclusion des domaines. Retirez toute source qui ne satisfait pas vos contrôles d'accès et de conformité, conformément aux recommandations d'IBM sur l'éthique et la conformité réglementaire.
- Champs. Nommez chaque colonne, son type et un exemple de ligne valide.
- Règles de valeur vide et de conflit. Précisez ce que la sortie enregistre lorsqu'un champ est absent ou que deux valeurs de page se contredisent.
- Preuves. Exigez l'URL source à côté de chaque ligne lorsque le destinataire doit auditer l'extraction.
- Vérification humaine. Définissez les cas fragiles, vides ou contradictoires qui bloquent toute utilisation ultérieure.
- Cadence. Indiquez si la livraison met fin à la mission ou si le même brief doit être répété.
La sortie doit correspondre au brief. Un livrable utile contient le tableau structuré, les URL sources conservées lorsque cela est requis, des marqueurs de vérification visibles et un relevé clair des cas ignorés ou vides. L'acceptation signifie que le destinataire peut contrôler le fichier à partir des sources et des règles nommées. Si la même mission doit être répétée, le lot accepté devient alors une preuve pour décider d'utiliser un outil de scraping.
Règle de preuve : une ligne dépourvue de la preuve exigée par le brief est incomplète, même si la valeur extraite paraît plausible.
Demander une mission IA cadrée
Quels sont les critères de livraison d'une extraction par IA ?
Une livraison est acceptée lorsque le fichier livré respecte le schéma convenu et fait apparaître tous les cas que la règle de vérification impose de contrôler. Le but n'est pas une démonstration soignée. Le but est un livrable inspectable lié à la liste de sources.
Contrôlez la livraison par rapport au brief :
- Chaque colonne livrée respecte le nom et le type convenus.
- Les valeurs manquantes utilisent la règle convenue pour les valeurs vides.
- Les valeurs contradictoires utilisent la règle de conflit convenue.
- Chaque ligne conserve son URL source lorsque la preuve était requise.
- Chaque ligne fragile porte le marqueur de vérification convenu.
- Les sources ignorées restent visibles au lieu de disparaître du livrable.
- La livraison indique si la mission s'est arrêtée ou si elle sera répétée.
Ces critères montrent aussi si vous avez besoin d'un logiciel après le lot. Si un fichier accepté clôt la tâche, la mission cadrée est terminée. Si les mêmes sources et le même schéma doivent revenir selon une cadence, la décision suivante porte sur l'outil, le suivi, les prompts ou les sélecteurs, les nouvelles tentatives et la propriété du pipeline. Cette décision part d'une sortie inspectée plutôt que d'une matrice générique de fonctionnalités.
N'ajoutez pas de champs après l'extraction sans mettre à jour le brief. Un nouveau champ modifie le schéma et le contrôle d'acceptation. Gardez le livrable demandé assez étroit pour qu'un relecteur puisse comparer les lignes à leurs sources et résoudre les cas signalés.
Le scraping de données par IA est-il légal ?
Cet article ne donne pas de conseil juridique et n'énonce pas de règle universelle de légalité. IBM indique que le web scraping n'est pas en soi illégal ou contraire à l'éthique, mais qu'il peut devenir problématique lorsqu'il est réalisé de manière contraire à l'éthique dans sa présentation de l'éthique du scraping par IA. IBM indique aussi que les praticiens doivent recueillir les données de manière éthique et respecter les cadres réglementaires applicables à la collecte de données dans les mêmes recommandations.
Vérifiez chaque source avant une exécution. Les pages sécurisées peuvent exiger une authentification, et IBM indique que les scrapers par IA peuvent les utiliser lorsque les conditions du site autorisent l'accès. IBM qualifie aussi la collecte de données privées, la surcharge des serveurs et le plagiat de contenu de pratiques généralement contraires à l'éthique. Les praticiens doivent respecter les cadres réglementaires applicables à la collecte de données dans les recommandations d'IBM sur l'éthique du scraping par IA.
Si une source ne satisfait pas ces contrôles, retirez-la de la liste. Une mission cadrée limite le lot convenu.
Quand faut-il passer d'une mission cadrée à un outil de scraping ?
Passez à un outil lorsque les sources et le schéma acceptés doivent être traités selon une cadence et que vous êtes prêt à exploiter le pipeline. Cette responsabilité comprend le suivi, les sélecteurs ou les prompts, les nouvelles tentatives et la gestion des échecs. Le positionnement de Browse AI pour le scraping et le suivi est un exemple de produit destiné aux workflows de pages récurrents dans son comparatif publié.
Restez sur une mission cadrée lorsque la liste de sources est fermée, le schéma connu et qu'un tableau accepté met fin à la demande. Passez à un outil lorsque la même mission doit continuer. Si les sources ou les champs restent imprécis, révisez le brief avant d'évaluer des produits.
La séquence est courte :
- Définissez la liste de sources et le schéma.
- Exécutez une extraction bornée.
- Vérifiez les preuves et les lignes signalées.
- Acceptez ou révisez le livrable.
- Ne choisissez un outil récurrent que si la mission acceptée doit continuer.
Cette séquence rend la décision d'achat précise. Vous choisissez un logiciel pour un ensemble de sources, un schéma et une règle de vérification éprouvés. Vous n'achetez pas une étiquette de catégorie.
Demander une mission IA cadrée
Écrit par Tileo, opérateur de Pitstop.