Web scraping con IA: elija un trabajo de extracción acotado o una herramienta de scraping
Según la definición de scraping con IA de IBM, el scraping con IA usa inteligencia artificial para automatizar la extracción de datos de sitios web, con el objetivo de recopilar y procesar datos de manera más eficiente e inteligente que con métodos manuales. Para tomar una decisión práctica, empiece por el trabajo, no por el producto. Indique las URL de origen, defina las columnas de salida, explique cómo tratar los valores ausentes o inciertos y decida qué filas necesitan revisión. Use un trabajo de extracción acotado para un lote cerrado y un archivo aceptado. Elija una herramienta de scraping cuando las mismas fuentes y el mismo esquema deban ejecutarse de forma programada y quiera hacerse cargo del pipeline. Antes de seguir cualquiera de las dos vías, evite extraer datos privados, sobrecargar servidores o plagiar contenido. Cumpla también los marcos regulatorios pertinentes para la recopilación de datos, de acuerdo con las orientaciones éticas de IBM.
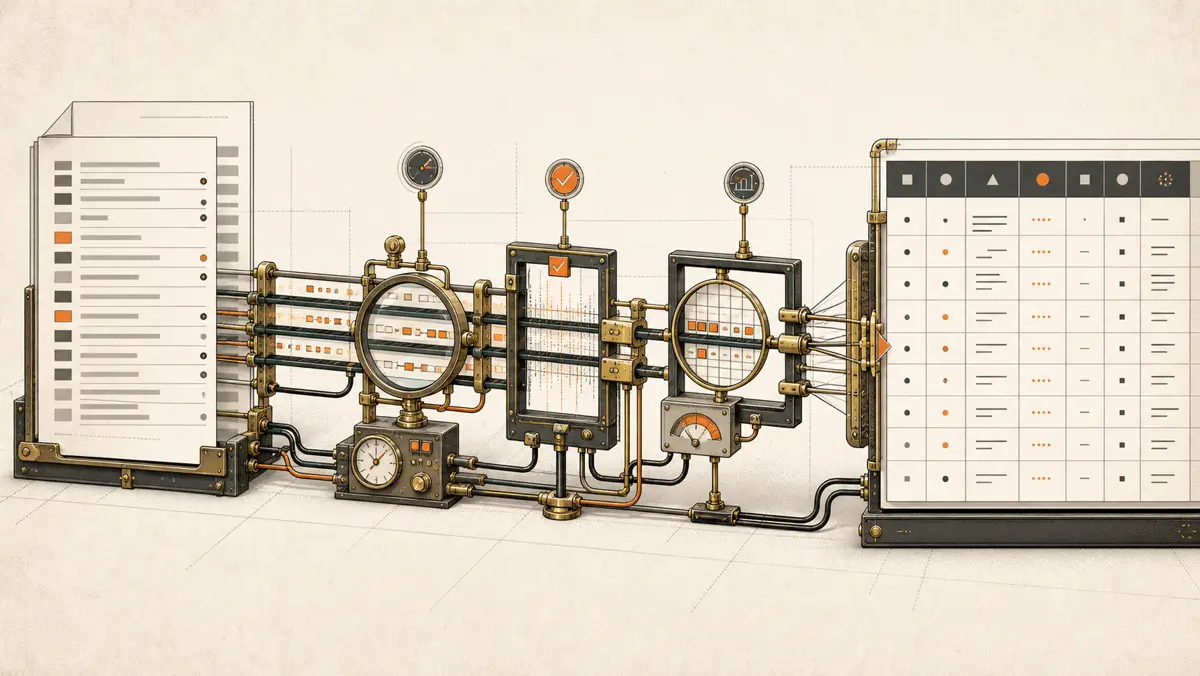
¿Qué es el scraping con IA?
El scraping con IA es la extracción de datos de sitios web guiada por modelos que interpretan el contenido, no solo por selectores fijos de página. IBM define el término como el uso de inteligencia artificial para automatizar la extracción de sitios web y procesar los datos recopilados en su descripción del scraping con IA.
Los scrapers web tradicionales usan selectores CSS, expresiones XPath y lógica codificada de forma rígida. Según la comparación de IBM entre el scraping tradicional y el scraping con IA, la extracción asistida por IA puede interpretar el contenido por su significado y trabajar con entradas como imágenes, diagramas y PDF. Esa diferencia describe el método de extracción. No decide si necesita un producto permanente de scraping.
Para un operador, el punto de partida útil es un brief de trabajo escrito. Convierte «extraiga estos sitios» en un archivo que alguien puede revisar y aceptar.
- Indique las URL o los dominios de origen incluidos en la ejecución.
- Defina las columnas de salida, los tipos de campo y un ejemplo de fila válida.
- Indique qué debe registrarse cuando falte un campo o dos valores entren en conflicto.
- Conserve la URL de origen con cada fila cuando el archivo necesite un rastro de evidencias.
- Marque los casos que una persona debe revisar antes de cualquier uso posterior.
- Fije la condición de parada como un lote o un monitor periódico.
Regla de decisión: si no puede indicar las fuentes, los campos y la regla de revisión, no está listo para comparar productos de scraping.
¿Cuál es la mejor herramienta de scraping con IA para su trabajo?
La mejor opción es la que encaja con su lista de fuentes, esquema de salida, frecuencia y decisión de propiedad. Una lista genérica de herramientas no puede tomar esa decisión porque los productos incluidos resuelven trabajos distintos. La selección de Gumloop agrupa lienzos de workflows sin código, scrapers de escritorio, extensiones de navegador y API para desarrolladores en la misma categoría. También aconseja probar los productos en sus propias páginas en su comparación de scrapers web con IA.
Use esta tabla para elegir el modelo operativo antes de elegir una marca.
| Punto de decisión | Trabajo de extracción acotado | Herramienta o API de scraping |
|---|---|---|
| Fuentes | Una lista cerrada de URL o dominios para el lote aceptado | Las mismas fuentes vuelven con una frecuencia definida |
| Salida | Una tabla estructurada con las columnas acordadas | Un pipeline que sigue produciendo el esquema acordado |
| Revisión | Las filas débiles o contradictorias incluyen indicadores de revisión | Su equipo gestiona la revisión en el pipeline activo |
| Operaciones | La ejecución termina tras la entrega y la aceptación | Su equipo gestiona la supervisión, los prompts o selectores, los reintentos y los fallos |
| Siguiente decisión | Repetir el trabajo solo de forma intencionada | Mantener el producto configurado y en funcionamiento |
Un monitor sin código encaja cuando las mismas páginas necesitan comprobaciones programadas y tratamiento de cambios. Browse AI se presenta para workflows de scraping y monitorización y para un uso no técnico en la comparación de herramientas de Browse AI. Una API para desarrolladores encaja con una aplicación o un agente que necesita contenido de páginas o campos estructurados a partir de URL. Un trabajo acotado encaja con una lista cerrada de fuentes, columnas conocidas y una sola entrega.
No trate un benchmark público ni un hilo de discusión como prueba de aceptación para sus fuentes. Un hilo de Reddit sobre un scraping fallido en el mundo real es un relato anecdótico. No demuestra que un método vaya a funcionar o fallar en sus páginas en esa discusión de r/webscraping.
Regla de selección: compare primero los modelos operativos. Pruebe una vía preseleccionada con las URL y las columnas exactas del brief.
¿Puede ChatGPT hacer web scraping?
ChatGPT puede obtener sitios web en algunos casos, pero Gumloop afirma que no puede extraer por completo una página web por sí solo. Gumloop remite a los lectores a herramientas de scraping dedicadas cuando un workflow necesita extracción y razonamiento del modelo en su guía de scrapers con IA.
Por eso, una respuesta de chat sobre una URL es distinta de una entrega de extracción. La entrega definida en este brief contiene una lista de fuentes, un esquema, reglas para páginas ausentes o bloqueadas, indicadores de revisión y un archivo que el destinatario puede comprobar. Si su pregunta inmediata es si determinados campos existen en determinadas páginas, defina un lote acotado. Si la salida aceptada debe actualizarse en una hoja, una API o un agente, evalúe un producto de scraping para ese trabajo periódico.
El mismo límite se aplica cuando las páginas contienen datos no estructurados. La extracción asistida por IA puede interpretar el contenido por su significado según la comparación de IBM con los selectores fijos. Una herramienta de scraping dedicada proporciona la capa de extracción que envía el contenido de la página a un modelo según la guía de Gumloop. Los desarrolladores también hablan de esta separación cuando trabajan con datos web no estructurados, pero un hilo comunitario no es documentación del producto en la discusión de desarrolladores de OpenAI.
Use estas preguntas para evitar que un experimento con ChatGPT se convierta en una tarea de producción indefinida:
- ¿Qué URL exactas están dentro del alcance?
- ¿Qué columnas debe contener la salida?
- ¿Qué valor representa un campo ausente?
- ¿Qué conflictos o filas inciertas requieren revisión?
- ¿El trabajo termina tras un archivo aceptado o debe repetirse de forma programada?
¿Puedo usar IA para extraer sitios web como un trabajo acotado?
Sí, cuando puede definir las fuentes, el esquema, las evidencias, la regla de revisión y la condición de parada antes de la ejecución. El trabajo acotado es un contrato de ejecución para una salida. No afirma que se pueda acceder a todas las fuentes ni que cada valor extraído esté listo para usarse.
Escriba el brief en este orden:
- Fuentes. Enumere las URL exactas o defina la regla de inclusión de dominios. Elimine cualquier fuente que no supere sus comprobaciones de acceso y cumplimiento, de acuerdo con las orientaciones de IBM sobre cumplimiento ético y normativo.
- Campos. Indique cada columna, su tipo y un ejemplo de fila válida.
- Reglas para vacíos y conflictos. Especifique qué registra la salida cuando falta un campo o dos valores de una página no coinciden.
- Evidencias. Exija la URL de origen junto a cada fila cuando el destinatario deba auditar la extracción.
- Revisión humana. Defina qué casos débiles, vacíos o contradictorios bloquean el uso posterior.
- Frecuencia. Indique si la entrega pone fin al trabajo o si se repite el mismo brief.
La salida debe coincidir con el brief. Una entrega útil contiene la tabla estructurada, las URL de origen conservadas cuando sean necesarias, indicadores de revisión visibles y un registro claro de los casos omitidos o vacíos. La aceptación significa que el destinatario puede comprobar el archivo con las fuentes y las reglas indicadas. Si el mismo trabajo debe repetirse, el lote aceptado se convierte en evidencia para decidir sobre la herramienta de scraping.
Regla de evidencia: una fila sin la evidencia exigida por el brief está incompleta, aunque el valor extraído parezca plausible.
Solicitar un trabajo de IA acotado
¿Cuáles son los criterios de entrega de una ejecución de scraping con IA?
Una entrega se acepta cuando el archivo entregado sigue el esquema acordado y muestra todos los casos que la regla de revisión exige comprobar. El objetivo no es una demostración pulida. Es un artefacto inspeccionable vinculado a la lista de fuentes.
Compruebe la entrega frente al brief:
- Cada columna entregada coincide con el nombre y el tipo acordados.
- Los valores ausentes usan la regla acordada para valores vacíos.
- Los valores contradictorios usan la regla de conflicto acordada.
- Cada fila conserva su URL de origen cuando se exigieron evidencias.
- Cada fila débil incluye el indicador de revisión acordado.
- Las fuentes omitidas siguen visibles en lugar de desaparecer de la entrega.
- La entrega indica si el trabajo ha terminado o se repetirá.
Estos criterios también muestran si necesita software después del lote. Si un archivo aceptado cierra la tarea, el trabajo acotado ha terminado. Si las mismas fuentes y el mismo esquema deben volver de forma programada, la siguiente decisión abarca la herramienta, la supervisión, los prompts o selectores, los reintentos y la propiedad del pipeline. Esa decisión parte de una salida inspeccionada, no de una matriz genérica de funciones.
No añada campos después de la extracción sin actualizar el brief. Un campo nuevo cambia el esquema y la comprobación de aceptación. Mantenga el artefacto solicitado lo bastante limitado para que un revisor pueda comparar las filas con sus fuentes y resolver los casos marcados.
¿Es legal el scraping de datos con IA?
Este artículo no ofrece asesoramiento jurídico ni establece una regla universal de legalidad. IBM afirma que el web scraping no es ilegal ni poco ético por sí mismo, pero puede resultar problemático si se realiza de forma poco ética en su explicación sobre la ética del scraping con IA. IBM también afirma que los profesionales deben recopilar datos de forma ética y cumplir los marcos regulatorios pertinentes para la recopilación de datos en la misma orientación.
Compruebe cada fuente antes de una ejecución. Las páginas seguras pueden requerir autenticación, e IBM afirma que los scrapers con IA pueden usarlas cuando las condiciones del sitio permiten el acceso. IBM también considera que la extracción de datos privados, la sobrecarga de servidores y el plagio de contenido son prácticas comúnmente poco éticas. Los profesionales deben cumplir los marcos regulatorios pertinentes para la recopilación de datos en las orientaciones de IBM sobre la ética del scraping con IA.
Si una fuente no supera esas comprobaciones, elimínela de la lista. Un trabajo acotado limita el lote acordado.
¿Cuándo debe pasar de un trabajo acotado a una herramienta de scraping?
Cambie cuando las fuentes y el esquema aceptados deban ejecutarse de forma programada y esté preparado para hacerse cargo del pipeline. La propiedad incluye la supervisión, los selectores o prompts, los reintentos y la gestión de fallos. El posicionamiento de Browse AI para scraping y monitorización es un ejemplo de un producto dirigido a workflows periódicos de páginas en su comparación publicada.
Mantenga un trabajo acotado cuando la lista de fuentes esté cerrada, el esquema sea conocido y una tabla aceptada ponga fin a la solicitud. Pase a una herramienta cuando el mismo trabajo deba seguir ejecutándose. Si las fuentes o los campos aún no están claros, revise el brief antes de evaluar productos.
La secuencia es corta:
- Defina la lista de fuentes y el esquema.
- Ejecute una extracción acotada.
- Revise las evidencias y las filas marcadas.
- Acepte o revise la entrega.
- Elija una herramienta periódica solo si el trabajo aceptado debe continuar.
Esta secuencia concreta la decisión de compra. Elige software para un conjunto probado de fuentes, un esquema y una regla de revisión, no compra una etiqueta de categoría.
Solicitar un trabajo de IA acotado
Escrito por Tileo, operador de Pitstop.